Đang tải nội dung…
Danh sách bài viết
Kafka Hot Key: một merchant làm nghẽn cả partition
75% đơn hàng mang cùng key, 64 partition vẫn không chia được điểm nóng
Kafka Consumer & Consumer Group · Phần 7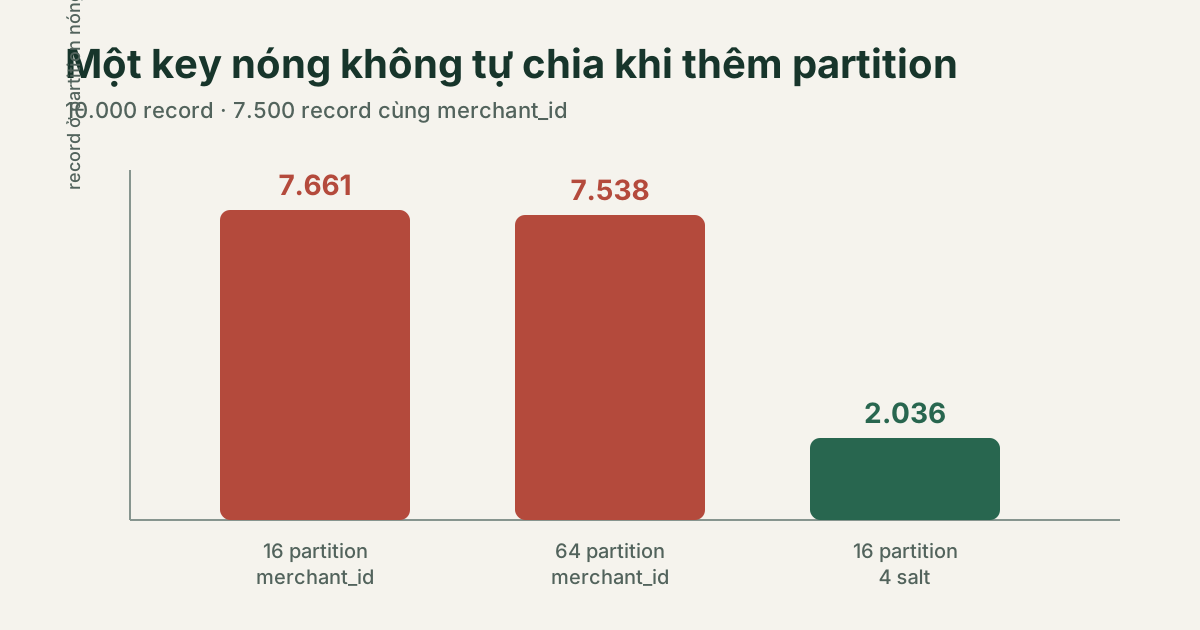
Bối cảnh hư cấu, bằng chứng lab thật. Fortex trong tuyến truyện này là bối cảnh hư cấu; Tom và Ben là nhân vật. Các cuộc trao đổi minh họa quá trình suy nghĩ. Số đo và assertion thuộc lab Docker được dẫn trong bài, không phải số liệu production của Fortex.
Hành trình ở Fortex · Chương 15
Chị Hà gửi cảnh báo: một partition đang nuốt gần hết lưu lượng
09:00 đúng ngày hội Siêu Sale 11/11. Không khí phòng kỹ thuật Fortex căng như dây đàn.
Chị Hà — Engineering Manager — mở toang cửa phòng incident, nét mặt nghiêm nghị. Cảnh báo của topic order-processing cho thấy lưu lượng đang lệch mạnh về một partition. Đây là tình huống hư cấu của Fortex; bài không dùng ảnh production hay gán cho nó những con số CPU, lag chưa được đo.
Chị Hà gõ ngón tay lên bàn: “Đáng nói là không chỉ khách của shop lớn bị chậm, mà người mua hàng ở các shop thời trang nhỏ lẻ cũng đang réo tổng đài vì nửa tiếng chưa nhận được email xác nhận đơn hàng!”
Ben vội vàng mở cấu hình của Kafka Producer lên xem. Cậu thở phào rồi quay sang chị Hà:
“Chị Hà ơi em kiểm tra rồi, logic gán key hoàn toàn đúng chuẩn sách giáo khoa! Hệ thống của mình yêu cầu các đơn hàng của từng merchant phải được xử lý tuần tự theo đúng thời gian, nên producer bên em đang đặt message key chính là merchant_id. Sáng nay một thương hiệu mỹ phẩm VIP chạy chiến dịch độc quyền trên sàn nên lượng đơn của họ chiếm tới 75% toàn hệ thống. Chắc do 16 partition ít quá nên bị quá tải thôi ạ. Em xin phép tăng số partition của topic từ 16 lên 64 ngay bây giờ, gắn thêm 48 consumer nữa vào là tải sẽ được san phẳng ngay!”
Chị Hà chưa kịp gật đầu thì Tom đã kéo ghế lại, nhẹ nhàng đặt tay lên vai Ben:
“Em đang muốn mở rộng con đường từ 16 làn xe lên 64 làn xe. Nhưng em có biết chiếc xe tải container khổng lồ kia đang chạy trên làn nào không?”
64 partition vẫn chỉ có đúng một chỗ nóng rực
Ben chớp mắt ngơ ngác: “Ủa anh, tăng lên 64 partition thì Kafka sẽ chia đều dữ liệu ra 64 phần chứ anh?”
“Đó là khi tin nhắn của em không có key,” Tom mỉm cười giải thích. “Còn khi tin nhắn có key, Kafka sẽ chọn partition theo mô hình nào?”
Ben sực nhớ lại:
Trong đó, p là chỉ số partition, k là chuỗi byte của key sau khi serialize, N là số partition hiện tại, còn H là hàm băm do partitioner của client lựa chọn.
Với Java producer mặc định, công thức cụ thể thường được viết:
Lab của bài dùng confluent-kafka 2.15.1 dựa trên librdkafka. Partitioner mặc định consistent_random dùng CRC32 cho key khác rỗng; murmur2 là một lựa chọn cấu hình riêng. Vì vậy điều lab kiểm chứng là tính tất định của cùng một key và hiện tượng dồn tải, không phải một kết quả băm Murmur2 cụ thể (librdkafka configuration).
Tom lấy bút dạ vẽ lên bảng: “Dù client dùng CRC32, Murmur2 hay một partitioner tương thích khác, điểm cốt lõi vẫn là tính tất định trong cùng một cấu hình. Cùng key merchant_id = 'vip' sẽ được đưa về cùng một partition khi số partition không đổi.”
“Điều đó có nghĩa là...” Ben há hốc mồm.
“Có nghĩa là dù em có tạo 16 partition, 64 partition hay 1.000 partition, thì toàn bộ 75% đơn hàng mang key vip kia vẫn sẽ bị băm vào đúng một partition duy nhất!” Tom nhấn mạnh.
Và bi kịch chưa dừng lại ở đó: Theo kiến trúc cốt lõi của Apache Kafka, trong cùng một Consumer Group, mỗi partition chỉ được gán cho duy nhất một consumer thread tại một thời điểm nhằm đảm bảo thứ tự xử lý nghiêm ngặt (Kafka design protocol).
“Dù em có cấp thêm 48 consumer mới toanh, thì 48 consumer đó chỉ ngồi nhìn partition nóng kia nghẽn thở! Không một ai có quyền nhảy vào partition đó để ‘gánh bớt việc’ cả!”
Bài lab thực nghiệm của WhyBit đã chứng minh chân lý này một cách trực quan bằng việc bắn đúng 10.000 record (trong đó 7.500 record thuộc về merchant VIP, và 2.500 record của các shop nhỏ rải rác):
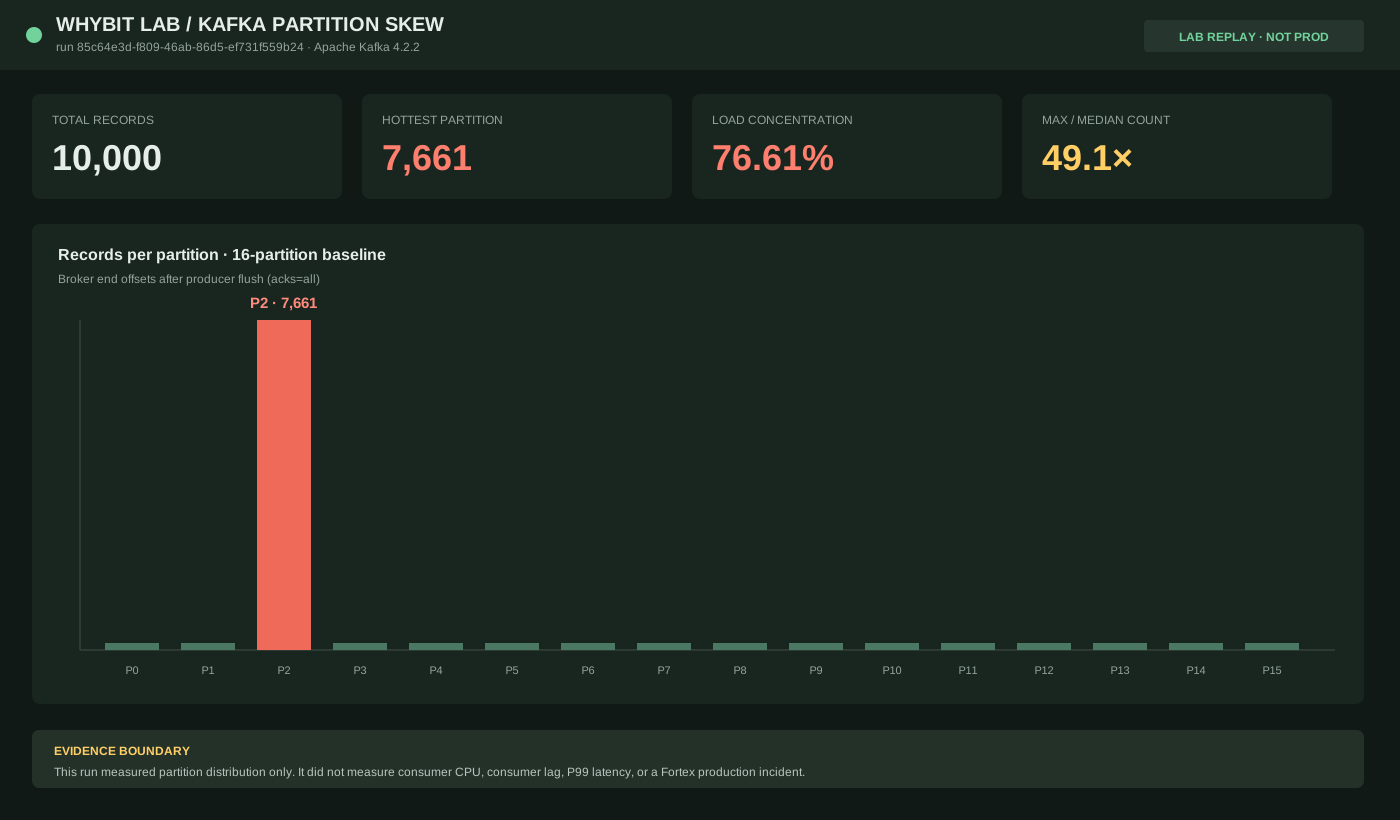
Dashboard này được dựng trực tiếp từ report.json của run 85c64e3d-f809-46ab-86d5-ef731f559b24, không phải ảnh production của Fortex. Lab đo end-offset theo partition; không đo CPU consumer, consumer lag hay P99.
| Cấu hình topic | Kỹ thuật phân phối | Số record ở partition nóng nhất | Tỷ lệ tải tập trung |
|---|---|---|---|
| 16 partition | Key gốc merchant_id | 7.661 | 76,61% |
| 64 partition | Key gốc merchant_id | 7.538 | 75,38% |
| 16 partition | VIP chia 4 Salt (order_id % 4) | 2.036 | 20,36% |
Nhìn vào bảng số liệu, Ben giật mình: Khi nâng từ 16 lên 64 partition, partition nóng nhất chỉ giảm từ 7.661 xuống 7.538 record (chênh lệch vài chục record là do các shop nhỏ khác tình cờ bị hash trùng vào đó). Cục than hồng 7.500 đơn của shop VIP vẫn nằm nguyên khối, không hề suy suyển!
Tài liệu cấu hình của Kafka Producer nhấn mạnh rất rõ: Tăng số lượng partition trong khi hệ thống đang chạy còn có thể làm đảo lộn việc map key của các record mới, phá vỡ tính bảo toàn thứ tự giữa các mốc thời gian (Kafka producer configs).
Ben ôm trán đúc kết lại câu trả lời phỏng vấn kinh điển:
“Tăng số lượng partition chỉ giúp tăng thông lượng xử lý song song giữa các key khác nhau. Nó hoàn toàn bất lực trong việc tăng tốc độ song song bên trong cùng một key!”
Key Salting: Đổi bài toán Thứ tự (Ordering) lấy Thông lượng (Throughput)
“Vậy bây giờ làm sao để chẻ nhỏ cục than hồng đó ra hả anh?” Ben sốt ruột.
“Ý tưởng tự nhiên nhất là: Nếu một key quá lớn, ta hãy biến nó thành nhiều subkey nhỏ!” Tom gợi ý. “Người ta gọi kỹ thuật này là Key Salting.”
Ben lập tức bắt tay vào code thử nghiệm: Với những merchant thông thường, cậu vẫn giữ nguyên key = merchant_id. Nhưng riêng với merchant VIP, cậu thêm một hậu tố ngẫu nhiên hoặc theo modulo đơn hàng:
const salt = order.id % 4;
const messageKey = isVip(merchantId)
  ? `${merchantId}:${salt}`
  : merchantId;
Kết quả trong phòng lab thực nghiệm lập tức thay đổi ngoạn mục:
- Lượng đơn của merchant VIP được rải đều sang 4 partition khác nhau.
- Đỉnh tải cao nhất của một partition giảm từ 7.661 xuống còn 2.036 record!
- Phân phối record theo partition phẳng hơn. Lab không chạy consumer nên không dùng kết quả này để khẳng định CPU hay consumer lag đã giảm bao nhiêu.
Ben sung sướng reo lên: “Thành công rồi anh Tom ơi! Tải giảm một phát gần 4 lần!”
Tom điềm tĩnh hỏi một câu làm Ben sững lại:
“Đơn hàng số 101 và đơn hàng số 102 của cùng một merchant VIP đó có còn được đảm bảo sẽ bay vào cùng một partition và đến tay consumer theo đúng thứ tự thời gian không?”
Ben khựng lại. Cậu tự tính nhẩm: Nếu đơn 101 có salt = 1 rơi vào Partition 2, còn đơn 102 có salt = 2 rơi vào Partition 5, thì hai consumer khác nhau sẽ nhặt hai đơn này một cách độc lập! Nếu mạng lag, đơn 102 hoàn toàn có thể được xử lý trước đơn 101!
“Salting chỉ bảo toàn thứ tự trong phạm vi từng bucket salt, chứ hoàn toàn phá vỡ tính toàn vẹn thứ tự của toàn bộ merchant,” Tom phân tích. “Đó là quy luật đánh đổi: Em muốn throughput tối đa thì em phải hy sinh strict ordering. Vấn đề là: Nghiệp vụ của Fortex thực sự cần thứ tự ở cấp độ nào?”
Xác định ranh giới nghiệp vụ (Ordering Boundary): Ai thực sự cần tuần tự?
Chị Hà kéo ghế ngồi lại cùng hai anh em. Chị lắng nghe và gật đầu:
“Đúng là ta phải quay về bài toán nghiệp vụ. Đội Product từng yêu cầu ‘mọi thứ phải theo thứ tự’, nhưng khi đi sâu vào chi tiết:
- Luồng xử lý đơn hàng (Checkout & Order Lifecycle): Khách mua hàng chỉ quan tâm các sự kiện của chính đơn hàng đó (
Created→Paid→Shipped) phải đúng tuần tự. Đơn của anh Nam và đơn của chị Lan cùng mua ở một shop thì đơn nào xử lý trước có quan trọng không? Hoàn toàn không! - Luồng đối soát tài chính (Financial Ledger / Quota): Đây mới là nơi duy nhất cần tính toán tuần tự tuyệt đối từng đồng ra đồng vào của tài khoản merchant để không bị âm tiền.”
Ben thở phào nhẹ nhõm: “Vậy thì bài toán đã quá rõ ràng!”
Tom và Ben cùng vạch ra 5 chiến lược lựa chọn ranh giới (Boundary):
- Chuyển Key sang
order_id: Áp dụng cho luồng xử lý đơn hàng. Mọi event của cùng một đơn hàng chắc chắn sẽ vào cùng một partition và đúng thứ tự; các đơn hàng khác nhau xử lý song song 100%, bài toán Hot Key tự động biến mất! - Key Salting có kiểm soát: Áp dụng khi bắt buộc phải gom nhóm theo merchant nhưng hạ tầng downstream có khả năng tự gom nhóm (re-aggregate) hoặc chấp nhận xử lý bất đồng bộ.
- Dedicated Topic cho Merchant VIP (Đường ưu tiên): Tách riêng các merchant có lưu lượng khổng lồ sang một Topic riêng (
orders.vip). - Custom Partitioner: Cài đặt thuật toán phân vùng thông minh ở tầng producer, nhưng cách này đòi hỏi mọi ngôn ngữ/client trong công ty phải đồng bộ thuật toán.
- Tách Command khỏi Analytics Event: Luồng ghi nhận nghiệp vụ khắt khe thì đi đường hẹp có sequence number; còn luồng gửi mail, bắn thông báo, thống kê thì fan-out thoải mái không cần key.
Hiện tượng Head-of-Line Blocking và giải pháp Dedicated Topic
Chị Hà hỏi tiếp: “Thế còn câu hỏi ban đầu của chị: Tại sao các shop nhỏ không tham gia sale cũng bị chậm đơn hàng?”
“Đó là hiện tượng Head-of-Line Blocking (Nghẽn đầu hàng),” Tom giải thích. “Khi chúng ta dùng chung một topic với số lượng partition hữu hạn, các merchant nhỏ có thể bị hàm băm xếp chung partition với ông lớn VIP. Record của họ sẽ phải chờ phía sau backlog của key nóng trên chính partition đó.”
Giải pháp tách Dedicated Topic cho VIP giải quyết triệt để vấn đề này:
- Các shop bình thường chạy trên
orders.standardvới retention và consumer group tiêu chuẩn. - Merchant VIP chạy trên
orders.vipvới số lượng partition lớn hơn, cụm consumer riêng biệt có CPU cao hơn. - Blast Radius (Bán kính ảnh hưởng) được thu hẹp: backlog của luồng VIP không còn nằm trong cùng topic và consumer group với luồng thường. P99 thực tế vẫn phụ thuộc broker, consumer và downstream, nên phải benchmark riêng trước khi đặt SLO.
Giám sát Kafka Lag như một Senior SRE: Đừng để con số Total Lag đánh lừa!
Ben mở dashboard Grafana lên để chỉnh sửa lại các biểu đồ giám sát. Tom nhắc nhở một kinh nghiệm xương máu khi đi trực chiến:
“Rất nhiều kỹ sư nhìn vào chỉ số Total Consumer Lag = 10.000 rồi vội vã kết luận hệ thống vẫn ổn vì tưởng 10.000 chia đều cho 20 partition thì mỗi bên chỉ trễ 500 tin. Nhưng thực tế có thể là: 19 partition có lag = 0, còn đúng 1 partition đang ôm trọn 10.000 tin lag! Đó là dấu hiệu của Hot Partition đang sắp phát nổ!”
Để phát hiện sớm Hot Key và Data Skew, một hệ thống chuẩn production bắt buộc phải theo dõi:
- Per-partition Lag: Vẽ biểu đồ lag chi tiết của từng partition độc lập, không chỉ cộng dồn tổng số.
- Tỷ lệ Max/Median Lag Ratio: Lấy partition có lag lớn nhất chia cho giá trị median lag. Nếu tỷ lệ này vượt quá 5x hoặc 10x, hệ thống đang bị lệch tải dữ liệu nghiêm trọng!
- Record Rate & Processing Time per Key: Định kỳ đo đạc thông lượng tin nhắn theo phân lớp key.
- Kiểm tra nghẽn ở Downstream Database: Như bài học tại Chương 10 — Kafka consumer lag bằng 0 nhưng dữ liệu downstream vẫn sai, nếu downstream database bị nghẽn connection pool thì việc tăng partition hay chia salt cũng chỉ dời điểm tắc nghẽn từ Kafka sang Database!
Hai chỉ số nên được chuẩn hóa trên dashboard:
Ở đây nᵢ là số record hoặc lag của partition i; Cmax đo tỷ lệ tập trung ở partition nóng nhất, còn S đo độ lệch so với partition trung vị. Trong run 16 partition của lab, Cmax = 7.661 / 10.000 = 76,61% và S = 49,1.
Bằng chứng kiểm chứng từ Docker Lab
Toàn bộ các assertion về phân phối dữ liệu được đo lường chính xác từ cụm container Apache Kafka 4.2.2 chính thức:
| Kịch bản thực nghiệm | Tổng record | Record ở partition nóng nhất | Tỷ lệ tập trung tải | Trạng thái assertion |
|---|---|---|---|---|
| 16 Partitions Baseline | 10.000 | 7.661 | 76,61% | Single hot key gây tắc nghẽn cục bộ |
| 64 Partitions Scale-out | 10.000 | 7.538 | 75,38% | Tăng partition không giải quyết được hot key |
| VIP chia 4 Salt Buckets | 10.000 | 2.036 | 20,36% | San phẳng đỉnh tải, giảm áp lực 3,7 lần |
Report JSON · Raw log · Mã nguồn lab · Run 85c64e3d-f809-46ab-86d5-ef731f559b24
Lưu ý về phạm vi thực nghiệm: Thử nghiệm đo đạc chỉ số End-Offset thực tế của từng partition sau khi Kafka Producer gửi dữ liệu với cấu hình
acks=allvà flush hoàn tất. Lab tập trung làm rõ bản chất thuật toán phân phối partition của Kafka, không giả lập benchmark bão hòa CPU consumer hay mạng phân tán đa broker.
Ben cập nhật ngay cuốn Runbook vận hành của Fortex. Cậu gạch bỏ dòng chữ ngây thơ cũ: “Thấy lag cao → Tăng partition”, và thay bằng quy trình chuẩn xác:
“Khi phát hiện lag tăng vọt: Mở biểu đồ Per-partition Lag để tìm Hot Partition; xác định tỷ lệ Max/Median Lag; rà soát xem có Hot Key hay không; sau đó mới đưa ra quyết định: Chuyển ranh giới key sang Order ID, áp dụng Salting, hay tách Dedicated Topic cho VIP.”
Cậu gửi bản thiết kế đề xuất sang chị Hà, ghi rõ từng sự đánh đổi: Cái nào giữ được thứ tự tuyệt đối, cái nào tăng tối đa throughput.
Tom đọc lướt qua tin nhắn trong kênh kỹ thuật, mỉm cười gật đầu rồi viết thêm một dòng:
“Đây là lần đầu tiên em không hỏi cluster có bao nhiêu partition trước khi hỏi bài toán nghiệp vụ thực sự cần thứ tự đến đâu!”
Fortex và các nhân vật hội thoại là bối cảnh hư cấu minh họa. Toàn bộ số đo, đồ thị khóa và log kỹ thuật trong bài viết đều được trích xuất nguyên bản từ phòng lab Docker có thể tái lập.
Trước: Chương 14 — Cache và CDC · Tiếp: Chương 16 — 2PC, Saga và compensation đến sớm