Đang tải nội dung…
Danh sách bài viết
Xóa 90% dữ liệu, vì sao file MySQL vẫn không nhỏ lại?
DELETE, purge và rebuild giải quyết ba việc khác nhau. Nhìn rõ bằng một bảng 50.000 dòng.
MySQL & InnoDB Internals · Phần 1
Bối cảnh hư cấu, bằng chứng lab thật. Fortex trong tuyến truyện này là bối cảnh hư cấu; Tom và Ben là nhân vật. Các cuộc trao đổi minh họa quá trình suy nghĩ. Số đo và assertion thuộc lab Docker được dẫn trong bài, không phải số liệu production của Fortex.
Hành trình ở Fortex · Chương 1/8
Ngày đầu tiên Ben muốn đóng ticket sớm
Ben vừa nhận việc ở Fortex đã xung phong dọn bảng sự kiện của một dịch vụ MySQL cũ. Công việc nghe vừa sức: xóa dữ liệu hết hạn, kiểm tra số dòng, báo lại dung lượng đã tiết kiệm. Cậu viết xong câu lệnh trước khi Tom uống hết cốc cà phê.
“Em kiểm tra rồi, dữ liệu cũ không còn. Chắc dashboard chưa cập nhật thôi.”
Tom kéo ghế lại, nhìn cả kết quả đếm dòng lẫn biểu đồ dung lượng.
“Có thể. Em đang mong con số nào giảm?”
“Dung lượng bảng. Xóa gần hết thì phải nhẹ đi chứ anh?”
Tom không sửa ngay chữ phải. Anh mở một môi trường Docker riêng, để Ben giữ quyền chọn câu lệnh đầu tiên. “Mình thử xem. Nếu file không nhỏ, em nghĩ dữ liệu mới sẽ cần một file lớn hơn nữa không?”
Ben gật đầu, rồi chần chừ. Hai dự đoán ấy nghe đều hợp lý, nhưng cậu chưa từng đặt chúng cạnh nhau. Đó là thí nghiệm đầu tiên hai người cùng làm ở Fortex.
Trước khi đụng đến câu lệnh xử lý
“Trước khi chạy, cho anh biết bảng này nằm ở đâu,” Tom nói.
Ben định trỏ vào tên database. Tom hỏi thêm: “File riêng của bảng, hay tablespace dùng chung?” Cậu mở cấu hình ra. Lần đầu tiên, tên engine và cách đặt dữ liệu không còn là mấy dòng setup để lướt qua.
Bài này dùng InnoDB với innodb_file_per_table=ON: bảng có file .ibd riêng. Đừng áp nguyên kết luận về việc thu nhỏ file vào một bảng đang dùng shared system tablespace hoặc general tablespace.
Bạn chỉ cần biết ba khái niệm. Page là khối lưu trữ mà InnoDB quản lý; với cấu hình mặc định thường gặp, một page là 16 KiB. Tablespace là vùng chứa các page. Purge là công việc dọn các phiên bản hoặc bản ghi đã xóa khi chúng không còn cần cho transaction nào nữa.
Một bảng có thể ít dòng hơn nhưng vẫn giữ những page đã được cấp phát. Trong những page đó, phần dung lượng trống có thể dùng cho lần ghi tiếp theo. Vì thế, chỉ nhìn COUNT(*) không cho biết file cần lớn bao nhiêu, và chỉ nhìn file cũng không cho biết còn bao nhiêu dòng đang dùng.
Để đối chiếu với một cách tổ chức dữ liệu khác, đọc tiếp bài về snapshot và VACUUM của PostgreSQL. Hai engine có cùng nhu cầu giữ phiên bản cũ, nhưng đừng coi purge của InnoDB và VACUUM là một cơ chế giống hệt nhau.
DELETE đã làm gì, và chưa làm gì?
Ben vẽ một hình chữ nhật rồi gạch đi phần lớn diện tích. “Em đang hình dung xóa là cắt phần này khỏi file.”
Tom vẽ thêm hai đường: một đường quanh các dòng còn nhìn thấy, một đường quanh toàn bộ vùng đã cấp phát. “Hình của em giải thích được query. Mình còn phải giải thích file.”
Sau khi transaction xóa commit, truy vấn thông thường ở snapshot mới không còn thấy những dòng đó. Phần dọn vật lý có thể đến sau, vì transaction cũ vẫn có thể cần đọc phiên bản trước khi xóa. Đây là lý do cần nhìn cả MVCC lẫn storage, thay vì nghĩ DELETE chỉ là thao tác cắt một đoạn byte khỏi cuối file. Tài liệu InnoDB về multi-versioning mô tả phần giữ phiên bản này.
Khi purge đã xử lý bản ghi, chỗ trống trở thành tài nguyên mà InnoDB có thể tái sử dụng. Nó không tự động biến thành yêu cầu thu nhỏ file .ibd. Nếu ngày mai bảng lại nhận dữ liệu, việc giữ sẵn dung lượng có thể tránh phải cấp phát lại.
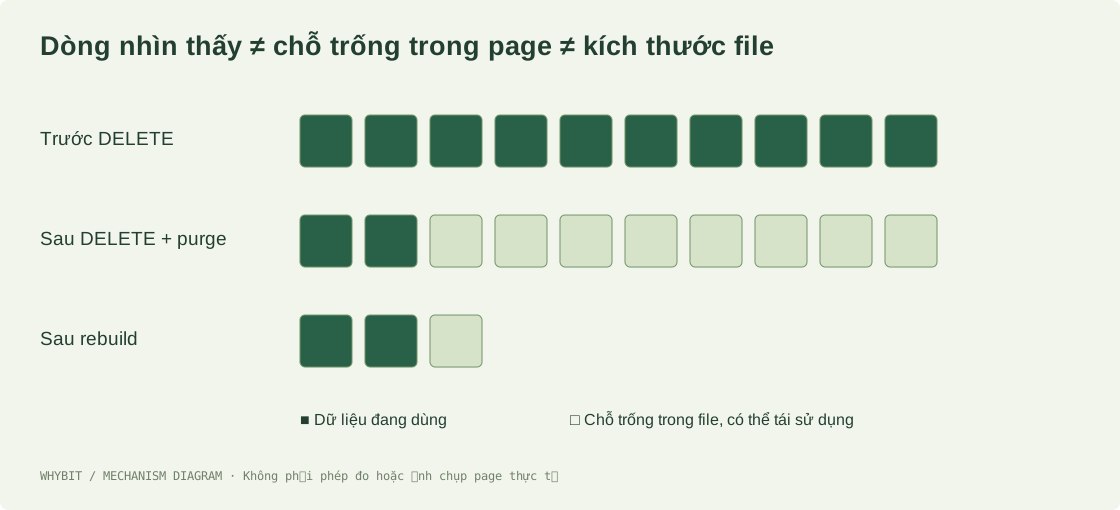
Sơ đồ cơ chế, không phải ảnh chụp layout page của lần chạy. Các ô chỉ minh họa phần đang dùng và phần có thể tái sử dụng.
Ở đây có một bẫy khi kiểm tra: số liệu thống kê dung lượng bảng trong metadata không phải lúc nào cũng là phép đo trực tiếp độ dài file. Vì muốn trả lời đúng câu “file có nhỏ lại không”, lab đọc kích thước .ibd bằng stat, đồng thời đếm dòng và kiểm tra dấu vân tay dữ liệu còn lại.
Dựng một bảng đủ nhỏ để tự chạy lại
Tom giao Ben chuẩn bị dữ liệu và ghi lại dự đoán trước khi chạy: số dòng, độ dài file sau xóa, độ dài file sau chèn lại. Anh chọn một database dùng một lần; bài học này không cần đánh cược dữ liệu của Fortex.
Lab dùng image mysql:8.4.7 được khóa thêm bằng digest, 1 CPU, tối đa 768 MB RAM, buffer pool 128 MB. Database nằm trên tmpfs giới hạn 512 MB, không mở port ra host và không có volume trỏ vào dữ liệu website.
tmpfs giúp thí nghiệm nhẹ và tự dọn sạch. Đổi lại, đây là phép đo kích thước file logic, không phải benchmark SSD, cũng không đo dung lượng file đĩa ảo của Docker Desktop. “52 MiB” ở bài này là độ dài events.ibd trong container.
Schema cố ý đơn giản:
CREATE TABLE events (
    id INT PRIMARY KEY,
    payload VARCHAR(256) NOT NULL
) ENGINE=InnoDB;
Payload được sinh xác định từ SHA2(id, 256), lặp bốn lần. Chạy lại cùng dataset sẽ có cùng dữ liệu. Có một primary key, không thêm secondary index để tránh trộn chi phí của nhiều cấu trúc vào câu hỏi đang xét.
Tải source ở phần Docker Lab cuối bài, giải nén rồi chạy từ thư mục gốc:
python3 labs/engine.py mysql-delete-space
Hoặc đăng nhập và bấm Chạy lab trên server ngay trong bài. Runner tạo database mới cho mỗi lần chạy; kết quả mới không ghi đè số đo đã dẫn trong bài.
Năm lần đo để phân biệt hai loại “giải phóng”
“Đừng chỉ đo lúc xóa xong,” Ben nói. “Nếu chỗ trống còn dùng được thì lần chèn lại mới trả lời được.”
Tom nhường bàn phím. Đó là câu hỏi đầu tiên trong buổi làm việc mà Ben tự bổ sung vào thí nghiệm. Hai người đi theo đúng năm mốc dưới đây; số đo là của lab đi kèm.
Đầu tiên, seed đủ 50.000 dòng. Sau đó xóa dải ID từ 1 đến 45.000:
DELETE FROM events WHERE id <= 45000;
SELECT COUNT(*) FROM events;
Kết quả cần thấy là 5.000 dòng. Nhưng lab chưa vội suy luận về purge chỉ từ số dòng đó. Nó bật bộ đếm purge_del_mark_records, ghi baseline trước khi xóa rồi đợi bộ đếm tăng ít nhất 45.000. Như vậy, phép đo sau xóa không chỉ đang chụp một thời điểm mà công việc purge còn chưa xử lý lượng bản ghi đã đánh dấu. Tài liệu purge giải thích vì sao bước này có thể diễn ra bất đồng bộ.
Tiếp theo, chèn lại đúng các ID vừa xóa, đo lại, rồi xóa chúng lần thứ hai. Cuối cùng mới chạy:
OPTIMIZE TABLE events;
SELECT COUNT(*) FROM events;
| Mốc đo | Số dòng nhìn thấy | Độ dài .ibd (byte) | MiB |
|---|---|---|---|
| Seed | 50,000 | 54,525,952 | 52,00 |
| Xóa 90% + chờ purge | 5,000 | 54,525,952 | 52,00 |
| Chèn lại dữ liệu | 50,000 | 54,525,952 | 52,00 |
| Xóa lần hai | 5,000 | 54,525,952 | 52,00 |
| OPTIMIZE TABLE | 5,000 | 8,388,608 | 8,00 |
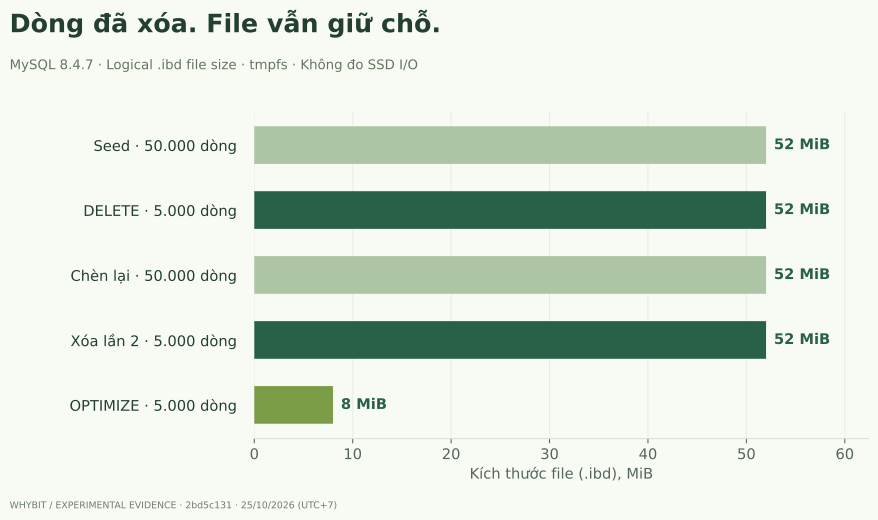
Biểu đồ được vẽ từ report của lần chạy đã xuất bản. MiB = 1.048.576 byte; trục bắt đầu từ 0. Xem SQL, stdout và stderr nguyên bản.
Hai dòng đáng nhìn nhất nằm ở giữa bảng. Xóa 90% dữ liệu không làm file nhỏ đi, nhưng chèn trở lại cũng không làm file lớn thêm trong lần chạy này. Có nghĩa phần dung lượng giữ lại đã phục vụ một nhu cầu thật: chứa dữ liệu mới.
Cũng cần đọc con số 8 MiB cho đúng. Còn 10% số dòng không có nghĩa file phải còn đúng 10% kích thước ban đầu. Cấp phát theo khối, cấu trúc cây, metadata và trạng thái bảng đều góp phần vào độ dài file. Lab xác nhận file nhỏ hơn sau rebuild, không đặt giả định file phải nhỏ theo một tỷ lệ tuyến tính.
OPTIMIZE có tác dụng, vậy tại sao không chạy sau mỗi lần DELETE?
Thấy file nhỏ lại sau rebuild, Ben lập tức mở phần lịch chạy job.
“Em thêm OPTIMIZE sau job retention nhé?”
Tom đặt tay lên cạnh bàn, không đụng vào bàn phím. “Em đã tìm được cách thu nhỏ file. Giờ giúp anh trả lời: ngày mai bảng có ghi đầy lại không?”
Ben dừng ở ô lịch chạy. Lần này, câu trả lời cần đến vòng đời dữ liệu của Fortex, không chỉ một lệnh SQL.
Vì mục tiêu vận hành có thể khác mục tiêu của biểu đồ.
Nếu bảng lưu sự kiện có kích thước tương đối ổn định — hôm nay xóa một phần, ngày mai ghi vào lượng gần tương đương — phần trống bên trong có thể là dung lượng dự phòng hữu ích. Rebuild để lấy lại rồi lại cấp phát khi ghi tiếp là một vòng công việc có chi phí.
Nếu dữ liệu được xóa vĩnh viễn và bảng sẽ giữ mức nhỏ hơn lâu dài, thu hồi file có ý nghĩa hơn. Với bảng file-per-table, OPTIMIZE TABLE có thể rebuild cấu trúc để thu lại phần không cần dùng. Cách nó thực thi, thời điểm lấy metadata lock và các ngoại lệ phải kiểm tra theo phiên bản, loại index và DDL đang có. Xem tài liệu OPTIMIZE TABLE, đừng hiểu chữ “online” thành “không bao giờ có lock”.
| Phương án | Nhận lại gì? | Chi phí và giới hạn | Khi đáng cân nhắc |
|---|---|---|---|
| Giữ nguyên sau DELETE | Chỗ trống sẵn để tái sử dụng, không phát sinh rebuild | File không nhỏ lại; cần đủ disk cho mức cấp phát hiện có | Bảng còn tiếp tục ghi và giữ quy mô gần ổn định |
| OPTIMIZE / rebuild | File riêng có thể nhỏ hơn | Đọc/ghi lại dữ liệu, cần dung lượng làm việc và cửa sổ metadata lock; tác động replica cần đo | Bảng thu nhỏ lâu dài, việc lấy lại disk có giá trị cụ thể |
| TRUNCATE | Bỏ toàn bộ dữ liệu, tạo lại không gian bảng theo cơ chế engine | Không lọc từng phần; có ràng buộc foreign key và semantics DDL | Dữ liệu toàn bảng thực sự có thể bỏ |
| Thiết kế retention bằng partition | Có thể loại dữ liệu theo đơn vị partition | Phải chọn partition key, kiểm tra ràng buộc và thay đổi schema | Dữ liệu có vòng đời theo thời gian, lượng lớn và đều |
Lab chỉ thực nghiệm hai dòng đầu. TRUNCATE và partition là phương án được tài liệu hỗ trợ, chưa được kiểm chứng trong lab này. Với file-per-table, đối chiếu thêm phạm vi thu hồi không gian trước khi chọn.
Những gì lab chưa trả lời thay production
“Vậy em báo đã giải phóng được từng này dung lượng trên hệ thống nhé?”
“Báo được kết quả lab,” Tom đáp. “Còn quyết định trên hệ thống thật, mình cần biết ổ đang chứa thứ gì và rebuild có đủ chỗ chạy không.” Ben đổi tiêu đề ghi chú từ cách sửa thành điều kiện để sửa.
Không có tải đồng thời trong thử nghiệm này. Không có replica, backup chạy cùng, bảng hàng trăm GB hay yêu cầu p99. Một rebuild mất ít thời gian ở đây không cho phép dự đoán một rebuild production mất bao lâu.
Trước khi xử lý disk gần đầy, Tom yêu cầu xác định disk đang nằm ở đâu: .ibd của bảng, undo, binlog, temporary files, hay file đĩa ảo Docker. Rebuild một bảng không giải quyết mọi loại tăng dung lượng. Ngay cả khi chỉ đúng bảng đó, một thao tác cần thêm dung lượng tạm cũng có thể là lựa chọn tệ lúc disk đã sát ngưỡng.
Tương tự, xóa lượng lớn trong một transaction có thể tạo ra một đợt công việc lớn cho undo, redo và replication. Chia batch có thể giúp kiểm soát từng đợt, nhưng batch size, thời gian chờ và tốc độ xóa phải theo tải thật. Bài này không đo các yếu tố đó, nên không đưa một con số batch “chuẩn cho mọi hệ thống”.
Khi gặp lại hiện tượng này
Trước khi gửi lại ticket, Ben tự viết danh sách kiểm tra. Tom chỉ thêm một yêu cầu: mỗi dòng phải giúp loại bỏ được một giả thuyết, không phải một nghi thức chạy cho đủ.
- Xác nhận
DELETEđã commit và số dòng còn lại đúng. - Xác định tablespace của bảng, thay vì chỉ nhìn cấu hình mặc định toàn server.
- Phân biệt file đang lớn, dữ liệu đang dùng và chỗ trống có thể tái sử dụng.
- Kiểm tra transaction lâu và hoạt động purge nếu phần dọn phiên bản bị giữ lại.
- Hỏi bảng có sớm ghi đầy lại không trước khi quyết định rebuild.
- Nếu rebuild, đo headroom disk, metadata lock, replication và cửa sổ vận hành trên bản sao phù hợp.
Điều cần nhớ ở lần nhìn biểu đồ disk tiếp theo: file chưa nhỏ lại chưa đủ để kết luận lệnh xóa có vấn đề. Trong lab này, câu trả lời nằm ở lần chèn trở lại — phần dung lượng tưởng như “chưa giải phóng” đã được dùng tiếp mà không cần mở rộng file.
Nguồn và bài đọc tiếp
Ben chưa đặt lịch rebuild. Cậu đề nghị xác nhận nhu cầu giữ dữ liệu và dung lượng làm việc trước, còn phần trống dùng lại được thì ghi nhận rõ. Tom đồng ý để cậu trình bày quyết định ấy với nhóm.
Các link tài liệu được đặt ngay tại lập luận cần đối chiếu. Toàn bộ code thí nghiệm nằm trong gói source cuối bài; report có assertions và raw log theo đúng phiên bản source.
Đọc tiếp: Một index tồn tại chưa có nghĩa truy vấn nên dùng nó. Bài đó tiếp tục câu chuyện từ page và lượng dữ liệu thực sự phải đọc, dùng PostgreSQL để nhìn rõ query plan.
Trang sổ Ben mang sang ngày mai
Ben để trống lịch OPTIMIZE. Trong sổ, cậu viết: “Dòng biến mất, chỗ trống dùng lại được, file nhỏ đi — phải hỏi riêng từng chuyện.” Bên dưới, cậu thêm một câu hỏi mới: nếu database làm việc theo page, một index giúp mình tránh đọc được bao nhiêu page?
Tom đọc xong, chỉ vào câu cuối. “Mai mình lấy câu này làm đầu bài.”
Chương tiếp: Có index rồi, vì sao database vẫn quét cả bảng? · Bắt đầu hành trình