Đang tải nội dung…
Danh sách bài viết
Xóa cache trước hay cập nhật DB trước? Khoảng trống mà CDC phải lấp
Giá sản phẩm cũ, hai thứ tự đều hở và một consumer WAL có thể sửa lại thế nào
Redis Internals & Cache Architecture · Phần 6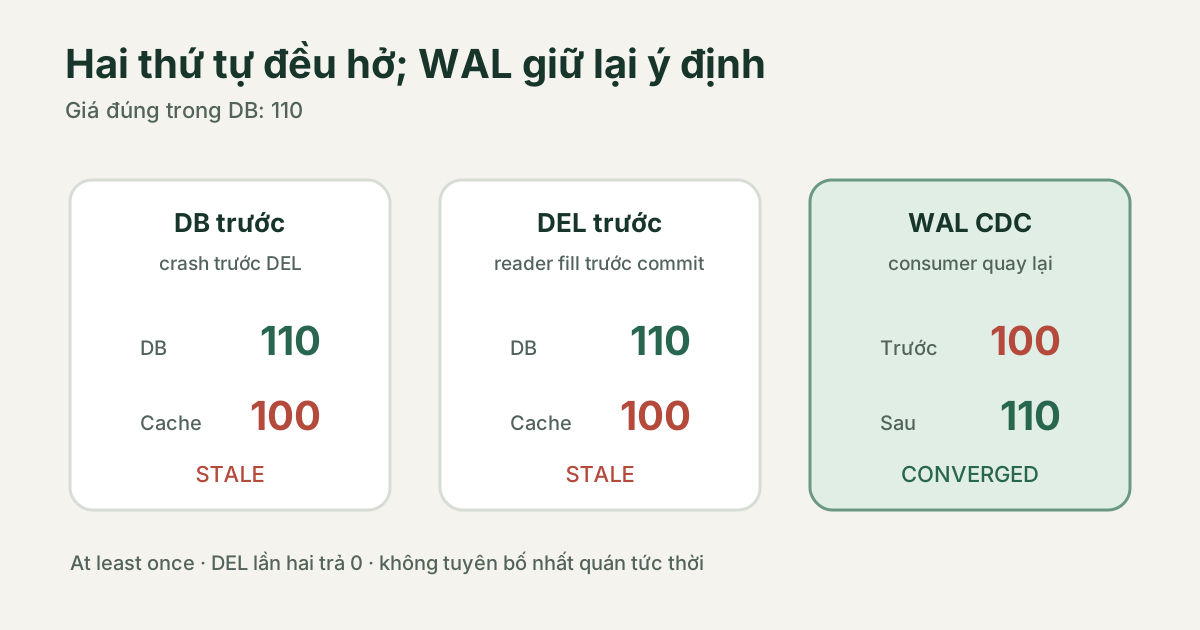
Bối cảnh hư cấu, bằng chứng lab thật. Fortex trong tuyến truyện này là bối cảnh hư cấu; Tom và Ben là nhân vật. Các cuộc trao đổi minh họa quá trình suy nghĩ. Số đo và assertion thuộc lab Docker được dẫn trong bài, không phải số liệu production của Fortex.
Hành trình ở Fortex · Chương 14
Đổi giá trên web admin 110$, khách hàng vẫn mua được 100$
Đúng 10:15 sáng, điện thoại nội bộ của Ben rung lên bần bật. Đầu dây bên kia là giọng bức xúc của một Merchant VIP:
“Tại sao tai nghe bên tôi vừa tăng giá từ 100$ lên 110$ từ nửa tiếng trước, trên trang quản trị đã báo cập nhật thành công, mà khách hàng ngoài ứng dụng vẫn mua ầm ầm với giá 100$? Ai sẽ bù khoản tiền chênh lệch này cho chúng tôi?”
Ben toát mồ hôi hột. Cậu vội vàng bật terminal kiểm tra:
- Truy vấn trực tiếp vào PostgreSQL:
SELECT price FROM products WHERE id = 1;→ Trả về con số 110. - Kiểm tra Redis Cache:
GET product:1→ Vẫn chình ình con số 100!
Ben gõ ngay lệnh DEL product:1 trên Redis. Ngay lập tức, trang bán hàng refresh lại và hiển thị đúng 110$.
Thở phào nhẹ nhõm, Ben mở ngay source code của backend ra soi. Cậu phát hiện ra logic cập nhật sản phẩm đang được viết: Chỉ chạy duy nhất một câu lệnh UPDATE products SET price = 110 WHERE id = 1 xuống PostgreSQL mà hoàn toàn không hề có dòng nào động đến Redis!
“Hèn gì!” Ben cười thầm. Cậu mở ngay một pull request nóng: Thêm đúng một dòng lệnh xóa cache ngay sau khi database commit:
await db.query('UPDATE products SET price = $1 WHERE id = $2', [newPrice, productId]);
await db.commit();
await redis.del(`product:${productId}`); // Ben thêm dòng này
Ben hí hửng kéo ghế sang khoe Tom: “Anh Tom ơi, em tìm ra thủ phạm rồi! Do ai đó lúc viết API đổi giá quên không xóa cache. Em vừa bổ sung lệnh redis.del ngay sau lệnh db.commit(). Làm thế này thì đảm bảo dữ liệu trong database đã ghi xong xuôi rồi mới xóa cache, không bao giờ lo lệch giá nữa!”
Tom nhìn dòng code mới của Ben, không khen cũng không chê. Anh chỉ vào đúng khoảng trống giữa dòng commit() và dòng redis.del() rồi hỏi:
“Nếu tiến trình Node.js bị Kubernetes OOM-kill, sập nguồn, hoặc mạng từ server backend sang Redis bị rớt đúng vào khoảng trống này thì sao?”
Hai lịch chạy kinh điển cùng sinh ra dữ liệu rác
Nụ cười trên môi Ben tắt ngấm.
Cậu nhận ra sự thật cay đắng: Database thì đã commit thành công con số 110$, nhưng lệnh redis.del chưa kịp gửi đi thì tiến trình đã chết! Giá trị 100$ trong Redis sẽ tiếp tục nằm trơ trơ ở đó, và khách hàng vẫn sẽ mua với giá cũ cho đến khi TTL hết hạn (hoặc sống vĩnh viễn nếu key không set TTL)!
“Thế thì...” Ben nhanh nhảu chữa cháy, “Thế thì em đổi ngược lại thứ tự! Em xóa cache trước, rồi mới cập nhật database sau!”
await redis.del(`product:${productId}`); // Xóa cache trước
await db.query('UPDATE products SET price = $1 WHERE id = $2', [newPrice, productId]);
await db.commit();
Ben lập luận: “Xóa cache trước thì an toàn hơn chứ anh! Nếu xóa cache xong mà DB commit lỗi, cùng lắm khách bị cache miss một lần rồi đọc lại dữ liệu cũ từ DB nạp vào cache. Đâu có bị kẹt dữ liệu sai!”
Tom lắc đầu, kéo bảng trắng lại: “Em mới chỉ nhìn một mình Writer đang chạy đơn độc. Em đã tính đến trường hợp có hàng trăm Reader (khách hàng xem sản phẩm) đang truy cập đồng thời chưa?”
Tom vẽ một dòng thời gian với hai tác nhân chạy song song:
Writer (Đổi giá 100 -> 110)            Reader (Khách xem hàng)
----------------------------------     ----------------------------------
1. redis.del('product:1')  (Cache trống)
                                       2. Đọc Redis: Cache Miss!
                                       3. Đọc DB: Thấy giá cũ là 100!
                                          (Vì Writer chưa kịp commit)
                                       4. Ghi 100 vào lại Redis!
5. db.query('UPDATE ... price = 110')
6. db.commit() (DB lên 110)
Mặt Ben tái mét. Cậu tự lẩm bẩm:
“Kinh hoàng thật... Reader đọc thấy 100 từ DB lúc Writer chưa commit, rồi vác con số 100 đó nạp đè lại vào Redis! Sau đó Writer mới commit 110. Kết quả cuối cùng: Database lưu 110, nhưng Redis lại bị nạp lại con số 100 cũ rích!”
Bài lab thực nghiệm của WhyBit đã tái hiện chính xác hai lịch trình thực thi đồng thời này:
| Lịch thực thi | DB cuối cùng | Cache cuối cùng | Bản chất nguyên nhân lỗi |
|---|---|---|---|
| DB trước, mất bước DEL | 110 | 100 | Commit DB và Invalidate Cache là hai side-effect phân tán, không thể atomic |
| DEL trước, reader chen ngang | 110 | 100 | Reader đọc trúng DB cũ trong lúc writer chưa commit rồi nạp đè lại cache |
Ảo tưởng mang tên “Xóa kép có trì hoãn” (Delayed Double Deletion)
“Em từng đọc trên mạng có người mách nước dùng chiêu Delayed Double Deletion (Xóa kép có trì hoãn),” Ben gãi đầu. “Nghĩa là: Xóa cache lần 1 → Cập nhật DB → sleep(500ms) → Xóa cache lần 2 để quét sạch những gì Reader vừa nạp nhầm. Cách này có ổn không anh?”
Tom bật cười: “Đó là giải pháp ‘cầu may’ kinh điển mà các ứng viên hay trả lời trong phỏng vấn khi chưa từng vận hành hệ thống lớn.”
Tom phân tích từng lỗ hổng chí mạng của chiêu thức này:
- Con số 500ms lấy từ đâu ra? Trong production, một đợt Garbage Collection (GC pause), một tích tắc mạng nghẽn, hoặc database replication lag có thể khiến câu query của Reader kéo dài 800ms. Reader sẽ nạp dữ liệu cũ vào Redis sau khi lần xóa thứ hai đã chạy xong!
- Nghẽn tài nguyên: Chạy
sleepngay trong luồng xử lý request sẽ giữ chặt connection pool và luồng xử lý của backend, bóp nghẹt throughput của cả hệ thống. - Nếu dùng hàng đợi bất đồng bộ (Queue): Đẩy lệnh xóa thứ hai vào queue để delay thì lại quay về bài toán ban đầu: Nếu service sập hoặc broker lỗi, ai đảm bảo lệnh xóa thứ hai chắc chắn được thực thi?
“TTL (Time-To-Live) chỉ giúp giới hạn ‘tuổi thọ’ của dữ liệu sai lệch, chứ không thể xóa bỏ khoảng trống bất nhất này,” Tom kết luận. “Muốn giải quyết triệt để, ta phải tìm một cơ chế mà ý định xóa cache phải bắt nguồn từ chính nơi dữ liệu được xác nhận thành công!”
Đưa sự kiện ra từ nơi đã commit: Sức mạnh của CDC và Postgres WAL
“Nơi duy nhất xác nhận sự thật là gì?” Tom hỏi.
“Là Transaction Log của Database!” Ben sáng mắt ra. “Trong PostgreSQL, đó là Write-Ahead Log (WAL). Một khi transaction đã commit, nó được ghi bền vững xuống WAL trên đĩa cứng!”
Chính xác! Thay vì để tầng ứng dụng cố gắng làm hai việc ghi phân tán (Dual Write), giải pháp chuẩn mực của các hệ thống quy mô lớn là sử dụng Change Data Capture (CDC):
- Ứng dụng chỉ làm duy nhất một việc: Cập nhật dữ liệu vào PostgreSQL và
COMMIT. - Cơ chế Logical Decoding của PostgreSQL đọc các thay đổi trực tiếp từ WAL và biến chúng thành một dòng dữ liệu (Stream).
- Các công cụ chuyên dụng như Debezium kết nối vào Replication Slot của PostgreSQL để đọc stream này và đẩy event sang Message Broker (hoặc trực tiếp gọi lệnh xóa cache).
Tài liệu chính thức của Debezium PostgreSQL connector chỉ rõ: Debezium lưu giữ vị trí WAL đã xử lý (LSN - Log Sequence Number). Nếu Debezium bị crash hoặc tắt đi, khi khởi động lại nó sẽ tiếp tục đọc chính xác từ LSN cũ. Cơ chế này cam kết việc phân phát sự kiện là At-Least-Once (ít nhất một lần).
“Nhưng anh ơi, At-Least-Once có nghĩa là event có thể bị gửi trùng lặp!” Ben thắc mắc. “Nếu lệnh xóa cache bị chạy lại hai lần thì sao?”
Tom mỉm cười: “Em thử gõ lệnh DEL product:1 hai lần liên tiếp trên Redis xem kết quả thế nào?”
Ben gõ thử:
- Lần 1: Redis xóa key và trả về
(integer) 1. - Lần 2: Key không còn nữa, Redis trả về
(integer) 0.
“Nó hoàn toàn Idempotent (bất biến với số lần gọi)!” Ben reo lên. “Dù có gửi lại 10 lần thì trạng thái cuối cùng của Redis vẫn là: key đó không tồn tại. Lần đọc tiếp theo của người dùng chắc chắn sẽ xuống DB lấy giá trị mới nhất!”
Lab WAL: Consumer tắt ngúm rồi quay lại phục hồi ngoạn mục
Trong phòng lab thực nghiệm của WhyBit, kịch bản CDC được thiết lập với PostgreSQL 17.6 sử dụng replication slot whybit_cache và plugin giải mã logic chuẩn test_decoding:
- Ban đầu cả PostgreSQL và Redis đều lưu giá của sản phẩm là
100. - Tiến trình Consumer xóa cache bị tắt hoàn toàn (mô phỏng sự cố sập worker).
- Trong lúc Consumer đang chết, Writer thực hiện cập nhật giá sản phẩm lên
110trong PostgreSQL và commit thành công. - Tại thời điểm này, Redis vẫn lưu giá cũ
100(khoảng trống trễ dữ liệu). - Sau đó, tiến trình Consumer được bật trở lại. Nó lập tức kết nối vào replication slot và trích xuất nguyên vẹn transaction log được bảo lưu từ WAL:
BEGIN 746
table public.products: UPDATE: id[integer]:1 price[integer]:110
COMMIT 746
- Consumer trích xuất
id: 1, gửi lệnhDEL product:1sang Redis. - Khi request đọc tiếp theo đến, hệ thống ghi nhận Cache Miss, đọc trực tiếp giá trị mới
110từ PostgreSQL và nạp lại vào Redis. Dữ liệu chính thức hội tụ hoàn toàn về110!
“Đó chính là giá trị vô giá mà CDC mang lại,” Tom giải thích. “Ý định xóa cache không còn là một lời hứa bấp bênh trong bộ nhớ RAM của một ứng dụng backend. Nó được neo chặt vào transaction log của cơ sở dữ liệu. Dù backend hay consumer có chết bao nhiêu lần, dữ liệu thay đổi vẫn nằm nguyên trong WAL chờ ngày được xử lý!”
Những góc khuất vận hành của CDC mà ứng viên Senior/Staff phải biết
Ben hào hứng: “Vậy từ nay cứ dùng CDC là bài toán cache hoàn hảo 100% rồi đúng không anh?”
“Không có giải pháp nào là viên đạn bạc,” Tom nghiêm túc. “CDC mua cho em tính bền vững và khả năng phục hồi, nhưng nó đặt lên vai đội ngũ vận hành những thách thức kỹ thuật rất lớn.”
Ben ghi lại danh mục các rủi ro vận hành cần kiểm soát:
- Nguy cơ tràn đĩa cứng vì Replication Slot (Disk Full):
Nếu tiến trình Consumer CDC bị treo hoặc dừng quá lâu, PostgreSQL sẽ bắt buộc phải giữ lại toàn bộ các file WAL trên đĩa cứng mà slot đó chưa đọc. Nếu không giám sát cẩn thận, ổ cứng của database server sẽ bị đầy 100%, kéo sập toàn bộ cơ sở dữ liệu! Tài liệu PostgreSQL cảnh báo rất rõ về việc bắt buộc phải cấu hình
max_slot_wal_keep_sizevà thiết lập cảnh báo retained WAL bytes (PostgreSQL replication slots). - Xử lý sự kiện sai thứ tự (Out-of-Order Events): Nếu scale nhiều consumer worker đọc song song từ message queue, event cập nhật giá 110 có thể bị xử lý sau event cập nhật giá 120. Cần partition message theo Entity ID hoặc đính kèm LSN/Version để từ chối các event cũ.
- Cạm bẫy Snapshot ban đầu: Khi khởi tạo CDC trên một bảng đã có sẵn hàng triệu dòng, connector phải chạy initial snapshot song song với stream WAL. Cần nắm vững cấu hình snapshot (Debezium snapshot modes) để tránh lock bảng hoặc đọc sót dữ liệu.
- Bão Cache Miss (Cache Stampede): Khi CDC xóa key của một sản phẩm cực hot, hàng nghìn request đọc đổ dồn xuống database cùng một tích tắc. Cần kết hợp kỹ thuật Singleflight / Mutex Lease như đã phân tích kỹ tại Chương 5 — Một key hết hạn, 12 request cùng đổ xuống database.
Bằng chứng kiểm chứng từ Docker Lab
Toàn bộ các assertion của bài lab được kiểm chứng tự động trong môi trường container độc lập:
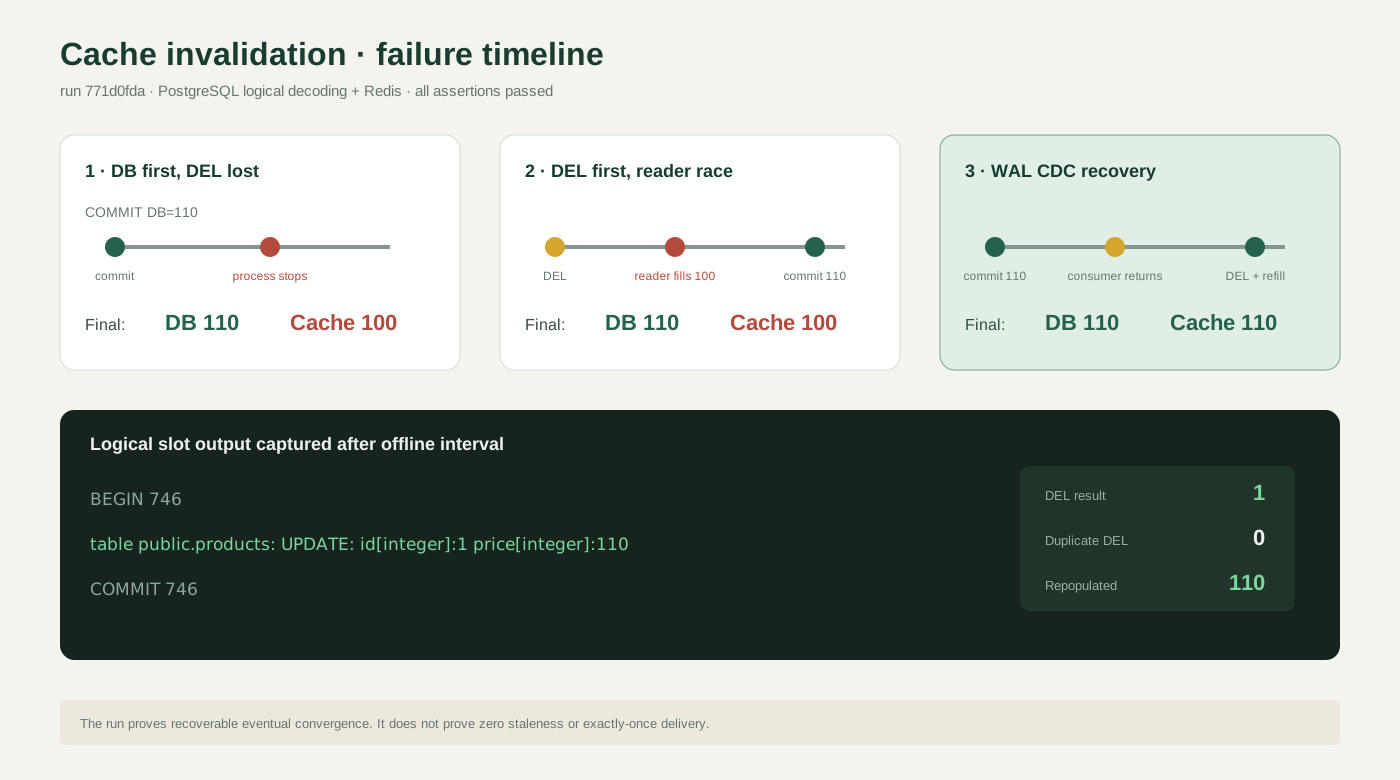
Hình báo cáo được dựng từ report.json của run 771d0fda-ed2c-4d43-8c88-78df7c125ba0: DB = 110, cache cũ = 100, WAL giữ transaction 746 và hai lần DEL trả về 1 rồi 0. Đây không phải dashboard production.
| Nhánh thực nghiệm | Điều kiện kiểm thử | Kết quả quan sát |
|---|---|---|
| DB first, mất bước DEL | Crash sau commit, trước lệnh DEL | DB = 110, Cache = 100 (Bất nhất vĩnh viễn) |
| DEL first, reader chen ngang | Reader đọc trúng DB cũ trước khi commit | DB = 110, Cache = 100 (Bị nạp đè dữ liệu cũ) |
| WAL CDC Recovery | Consumer offline trong lúc DB commit, sau đó bật lại | WAL lưu trữ thay đổi, Consumer đọc và DEL, Cache hội tụ về 110 |
| Idempotent DEL | Gửi lặp lại lệnh xóa key đã xóa | Lần 1 trả về 1, lần 2 trả về 0, trạng thái an toàn tuyệt đối |
Report JSON · Raw log · Mã nguồn lab · Run 771d0fda-ed2c-4d43-8c88-78df7c125ba0
Lưu ý về phạm vi thực nghiệm: Lab chạy trên một máy chủ đơn lẻ chứa PostgreSQL 17.6 và Redis 7.4.2 để cô lập hành vi logic. Thử nghiệm chứng minh khả năng lưu giữ thay đổi của logical slot và tính bất biến của lệnh DEL; không mô phỏng Debezium Kafka Connect cluster hay độ trễ phân tán trên production.
Ben đóng nắp laptop, tổng kết lại thiết kế mới cho Fortex:
- Tầng Writer chỉ làm đúng một nhiệm vụ: Cập nhật dữ liệu vào PostgreSQL và commit.
- Pipeline CDC lắng nghe WAL và phát đi sự kiện
ProductChanged. - Invalidation Worker nhận event và thực hiện
DELtrên Redis. - Dashboard Grafana bổ sung ngay hai chỉ số cảnh báo đỏ:
cdc_consumer_lag_secondsvàpostgres_wal_retained_bytes. - API trả về thêm trường
versioncủa sản phẩm để client nhận diện nếu dữ liệu vô tình bị cũ.
Tom mỉm cười hỏi: “Vậy hệ thống của em đã đạt được tính nhất quán tức thì (Strong Consistency) chưa?”
“Chưa anh,” Ben cười đáp. “Trong hệ thống phân tán, cache muôn đời chỉ là Eventual Consistency. Nhưng giờ đây, dữ liệu sai lệch không còn bị bỏ quên vĩnh viễn chỉ vì một dòng code bị sập nguồn. Và quan trọng nhất: tụi mình biết chính xác nó đang trễ bao nhiêu mili-giây!”
Fortex và các nhân vật hội thoại là bối cảnh hư cấu minh họa. Toàn bộ số đo, đồ thị khóa và log kỹ thuật trong bài viết đều được trích xuất nguyên bản từ phòng lab Docker có thể tái lập.
Trước: Chương 13 — Deadlock vô hình · Tiếp: Chương 15 — Kafka Hot Key